Source Registry в Obsidian: контрольовані RSS Signals
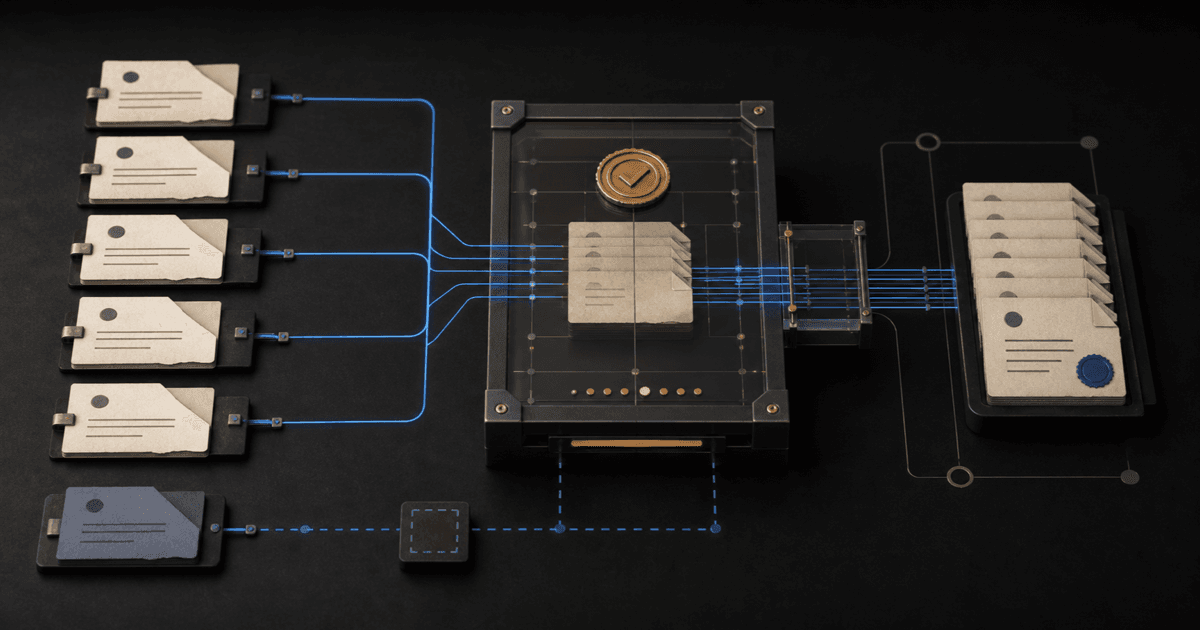
Перший ingestion нашого контрольованого RSS fixture завершився повідомленням created 1. Повторний запуск показав reused 1.
Ці два рядки виглядають скромніше за AI-generated summary або готовий Digest. Проте саме вони перевірили одну з головних властивостей Engineering Radar: повторний запуск не створює другу версію тієї самої події. Система пам’ятає identity Signal незалежно від того, скільки разів ми читаємо джерело.
У першій статті серії я пояснив, чому ми побудували Radar як local-first систему в Obsidian і не віддали AI право автономної публікації. Тепер розберемо першу технічну межу: як перетворити набір RSS URL на контрольований Source Registry, а елементи стрічки — на структуровані й дедупліковані Signals.
Головна ідея проста: RSS — лише транспорт. Надійність починається з контракту джерела, provenance, stable identity, обмеженого recovery та чіткого lifecycle повного тексту.
URL — ще не Source
Звичайному RSS reader достатньо URL і назви стрічки. Engineering Radar має відповісти на більше запитань.
- Це офіційне джерело чи community publication?
- Яку роль воно виконує: primary, discovery, engineering blog чи research?
- Чи дозволене його використання?
- Як часто його перевіряти?
- Чи є воно Critical?
- Коли була остання успішна перевірка?
- Чи заблоковане джерело після помилки або policy review?
- Які HTTP-механізми можна використати для conditional request?
Тому Source у нашому Vault — не рядок у конфігурації, а Markdown-файл із валідованим frontmatter і зрозумілим людині описом правил.
Контракт можна умовно розділити на п’ять груп:
- Identity: тип сутності, стабільний ID, schema version, назва й URL.
- Trust: роль, тип джерела, authority score та legal assessment.
- Operations: пріоритет, collection method, стан
enabled, cadence і rate-limit policy. - Health: остання спроба, останній success, error state і причина блокування.
- HTTP recovery: status,
ETag,Last-Modifiedі час останньої відповіді.
Source Registry читає ці файли, валідовує schema та будує runtime snapshot. Файл із неправильним URL, невідомим collection method або неповним frontmatter не стає активним Source. Duplicate ID теж не вирішується правилом «останній файл перемагає»: registry зберігає validation issue з посиланням на перше оголошення.
Це важливий shift. Якщо джерело впливає на публічний висновок, його правила не мають існувати лише в голові автора або в коді adapter.
П’ять production Sources і один fixture
У v0.1 ми зафіксували завершений scope із п’яти офіційних джерел:
- OpenAI;
- React;
- Next.js;
- GitHub Changelog;
- Cloudflare.
У каталозі Sources є ще шостий файл — mock RSS. Але він не є шостим production Source.
Mock має manual cadence, не використовує network і не викликає OpenAI. Його задача — детерміновано перевірити validation, ingestion, stable identity й atomic file creation. Він дає однаковий вхід незалежно від доступності зовнішнього сайту або поточних змін у реальній RSS-стрічці.
Це розділення потрібне і в документації, і в метриках. Фраза «у системі шість Source-файлів» описує inventory. Фраза «Radar обробляє п’ять production Sources» описує фактичний scope. Змішати їх — означає видати test fixture за production coverage.
Розширення до двадцяти джерел ми перенесли у post-MVP backlog. П’ять достатні, щоб перевірити робочий контур і різні зовнішні feeds, але недостатні, щоб оголосити масштабованість до будь-якої кількості adapters доведеною.
Source як trust boundary
Навіть валідний Source не обов’язково можна запускати. Runtime враховує business state:
- Source має бути
enabled; blockedReasonмає бути порожнім;legalAssessmentмає бутиapproved;- cadence має вказувати, що перевірка вже due.
Це захищає від поширеної помилки автоматизації: якщо endpoint технічно доступний, система не повинна автоматично вважати його дозволеним.
Наприклад, для OpenAI ми погодили використання офіційного RSS. Page extraction не стає дозволеним fallback лише тому, що RSS містить короткий excerpt. Для іншого джерела правила можуть відрізнятися, тому policy зберігається поруч із Source record.
Пріоритет теж є частиною контракту. Після простою Radar спочатку перевіряє Critical Primary і Discovery Sources, а вже потім решту. При цьому одна помилка не має зупиняти весь collection run: кожне джерело обробляється ізольовано, а recovery report показує passed і failed окремо.
Так Source Registry стає не каталогом посилань, а керованою trust boundary між зовнішнім інтернетом і приватним Vault.
Від RSS item до stable Signal
Коли Source дозволений і due, ingestion проходить кілька послідовних перевірок.
Спочатку виконується HTTP request із timeout. Якщо feed раніше повернув ETag або Last-Modified, Radar додає conditional headers. Відповідь 304 Not Modified завершує перевірку без повторного parsing.
Для нової відповіді система перевіряє HTTP status і content type. Потім XML parsing валідовує кожен item: guid, title, canonical link, observation date і description.
Далі формується stable identity. Концептуально вона виглядає так:
identityInput = sourceId + canonicalUrl + sourceItemId
signalId = observedTimestamp + stableShortHash(identityInput)

if signalPath exists:
  return reused

write temporary file
rename temporary file to signalPath
return created
Timestamp робить ID читабельним і допомагає сортуванню, а hash прив’язує його до Source та item. Назва статті не є частиною identity: publisher може виправити заголовок, не перетворюючи ту саму подію на новий Signal.
Створення файла атомарне. Спочатку Radar пише temporary file, потім перевіряє, чи не з’явився target паралельно, і лише після цього виконує rename. Якщо інший process уже створив Signal, temporary file видаляється, а результат стає reused.
Per-Source lock додатково не дозволяє запустити дві перевірки одного Source одночасно в межах process. Але головна гарантія idempotency зберігається у файловій identity, а не лише в оперативній пам’яті plugin.
Технічна примітка. Поточний v0.1 runtime відхиляє RSS response понад 2 MB і обробляє максимум 50 eligible items за одну перевірку Source. Це safety limits конкретної версії, а не універсальна рекомендація для будь-якого Radar.
Provenance важливіший за красиву дату
RSS pubDate часто виглядає достатньо переконливо, щоб одразу записати його як дату публікації. Ми свідомо цього не робимо.
У Signal дата зі стрічки зберігається як rss-observation. Поле publishedAt залишається порожнім, доки ми не маємо перевіреної first-party structured date.
Причина не лише в якості окремих feeds. Дата може означати publication, update, syndication або час перебудови стрічки. Якщо Radar перетворить observation на факт, помилка піде далі: у selection, Digest, сортування та публічний MDX.
Тому Signal зберігає provenance окремими полями:
- Source ID і Source item ID;
- requested URL і canonical URL;
- collection method;
- fetched-at timestamp;
- HTTP status;
- шлях до Source record;
- validation state.
Це робить невизначеність видимою. Краще мати порожній publishedAt із поясненням, ніж точну, але недоведену дату.
Recovery після простою без replay scheduler history
Локальний Obsidian не є high-availability service. Ноутбук може спати, Obsidian — бути закритим, а network — недоступним. Тому recovery є нормальною частиною роботи, а не винятком.
Найнаївніша реалізація спробувала б відтворити кожен пропущений scheduler run. Якщо Source мав cadence 6 годин, два дні простою могли б перетворитися на вісім майже однакових запитів. Це не додає coverage, але збільшує навантаження та кількість failure states.
Ми обрали іншу політику:
coverageFrom = max(lastSuccessfulCheck, now - 7 days)
Radar виконує одну актуальну перевірку кожного overdue Source й бере eligible items від останнього success, але не більше ніж за сім днів. Потім показує період простою, overdue count, passed, failed і created.
У live recovery v0.1 система знайшла п’ять overdue Sources. Результат: passed 5, failed 0, created 5. Наступний scheduled check показав overdue 0.
Це підтверджує recovery flow, але не гарантує, що семиденне вікно ніколи не пропустить старішу подію. Cap є свідомим trade-off між актуальністю, навантаженням і локальним характером системи. Якщо бізнес потребує повного історичного backfill, це інший workflow із власними правилами.
Full text — тимчасовий контекст, а не архів
Signal не зберігає необмежену копію чужого матеріалу. Його довготривала частина — structured artifact: identity, provenance, observation, analysis state і посилання на першоджерело.
Повний отриманий текст дозволено зберігати лише в Radar/Temporary Content/. Він існує тоді, коли потрібний контекст для AI analysis або Digest generation. Після закриття weekly cycle всі повні тексти видаляються.
Це правило одночасно вирішує кілька задач:
- Vault не перетворюється на неконтрольований контентний архів;
- backup не містить тимчасові third-party texts;
- retention можна перевірити окремо;
- cleanup не має права переходити в
Site Contentі торкатися опублікованих MDX.
Для фінального R2 cleanup retained full-text count дорівнював нулю. Саме це є потрібним evidence: не декларація «ми видаляємо тексти», а перевірений порожній temporary boundary після closure.
Як повний текст передається моделі, які поля повертає structured analysis і де проходить prompt-injection boundary — тема наступної статті.
Від першого spike до production scope
Ми не починали з п’яти зовнішніх feeds. Послідовність була навмисно короткою:
- Створити й провалідувати Source file.
- Встановити deterministic mock Source.
- Виконати ingestion й отримати
created 1. - Повторити його й отримати
reused 1. - Додати один офіційний OpenAI RSS.
- Розширити registry до п’яти погоджених official Sources.
- Додати conditional HTTP, timeout, Source lock, recovery window і failure isolation.
- Перевірити live recovery та healthy scheduled state.
Mock fixture довів idempotency й файловий boundary. Реальні feeds додали те, чого fixture принципово не міг показати: HTTP errors, content-type mismatch, remote format changes, conditional requests і policy differences.
Це хороший приклад MAE-підходу: spike не намагається довести production readiness. Він закриває одну конкретну невизначеність, після чого наступний інкремент додає новий contract і новий evidence.
Що це рішення дає — і чого не дає
Переваги file-based Source Registry:
- Source records залишаються читабельними без plugin;
- policy, cadence і health audit знаходяться поруч;
- idempotency не залежить від process memory;
- recovery має обмежену й пояснювану область;
- кожен Signal зберігає provenance;
- mock fixture дозволяє перевіряти ingestion без network.
Недоліки також конкретні:
- Markdown registry потребує strict schema validation;
- atomic file operations складніші за простий append;
- різні RSS feeds мають format edge cases;
- локальний Obsidian runtime не забезпечує безперервний collection;
- семиденний cap свідомо не покриває старіші події;
- п’ять Sources не доводять масштабованість post-MVP scope до двадцяти.
Для нашого сценарію це прийнятний trade-off. Ми оптимізували не абсолютну повноту архіву, а контрольований потік актуальних engineering Signals.
Мінімальний Source Registry для вашого Vault
Якщо ви хочете повторити підхід без нашого plugin source, почніть не з OpenAI API, а з deterministic ingestion.
- Створіть каталоги
Sources/,Signals/іTemporary Content/. - Опишіть Source schema й відхиляйте invalid records та duplicate IDs.
- Додайте один local fixture без network.
- Визначте stable identity до першого ingestion.
- Перевірте послідовність
created 1 → reused 1. - Додайте один official Source з явною usage policy.
- Обмежте timeout, response size та items per run.
- Додайте per-Source lock і failure isolation.
- Зафіксуйте recovery window та temporary-text retention.
- Лише після цього підключайте AI analysis.
Evidence snapshot v0.1
- Official production Sources: 5.
- Mock fixture: 1.
- Source Registry tests: 27.
- Source Registry commands: 10.
- Signal-file inventory на snapshot: 49.
- Recovery cap: 7 днів.
- Live recovery: 5 passed / 0 failed / 5 created.
- Post-recovery overdue: 0.
- Retained Temporary Content: 0.
49 Signal-файлів — це inventory на evidence snapshot, а не кількість Signals у production Digest. Кількість commands також не є доказом цінності системи; це лише розмір operational surface.
Наступний шар — analysis
Source Registry відповідає на питання: звідки прийшов Signal, чи дозволено використовувати джерело, чи бачили ми item раніше і який provenance можемо довести.
Він ще не відповідає на складніше питання: що ця зміна означає для engineering-команди?
У наступній частині розберемо Structured AI analysis: як передавати моделі тимчасовий контекст, отримувати schema-bound результат, захищатися від prompt injection і залишати severity та Recommended Action під людським контролем.
← Назад до блогу