Engineering Radar: контрольована AI-система в Obsidian
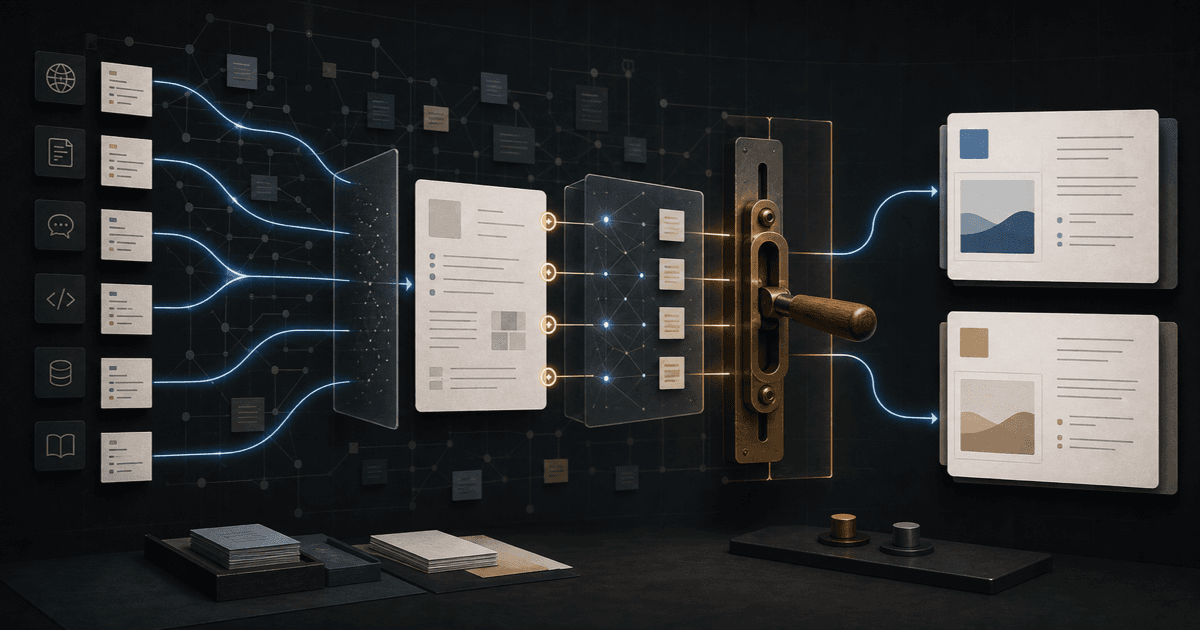
Ми побудували Engineering Radar, але слово «ми» тут потребує пояснення. Це автор і AI coding agent. Я визначав проблему, межі системи, бізнес-правила та критерії приймання. Агент допомагав проводити discovery, формалізувати рішення, писати код, тести й документацію. Кожне рішення, яке впливало на джерела, безпеку, редакційну якість або публікацію, залишалося за людиною.
Це важлива різниця. Engineering Radar — не AI, якому дали список RSS-стрічок і право самостійно писати блог. Це local-first система, яка перетворює потік технічних оновлень на структуровані Signals, допомагає людині сформувати двомовний тижневий Digest і передає у Git-репозиторій лише погоджені MDX-чернетки.
У першій частині серії я поясню, чому ми обрали саме таку конструкцію, чому робочим інтерфейсом став Obsidian, що ми свідомо не автоматизували та яку ціну має human-in-the-loop підхід.
Проблема була не у відсутності інформації
Розробники й технічні керівники рідко страждають від браку джерел. Проблема протилежна: changelogs, security advisories, release notes, engineering blogs і framework updates надходять постійно, але мають різну вагу та різний строк актуальності.
Звичайний RSS reader добре відповідає на запитання «що опублікували?». Для Engineering Radar цього недостатньо. Нам потрібно було щоразу відповідати щонайменше на п’ять інших запитань:
- Чи є матеріал новим, чи система вже бачила його раніше?
- Чи містить він breaking change, Critical Security signal або іншу зміну, яку не можна пропустити?
- Що саме змінилося порівняно з попередніми пов’язаними Signals — умовне «було → стало»?
- Яка рекомендована дія залишається актуальною: вивчити, перевірити, експериментувати чи змінити практику на рівні команди?
- Чи достатньо доказів, щоб включити Signal у публічний Digest?
Ручна обробка такого потоку має передбачувані слабкі місця. Вона залежить від доступного часу, ускладнює послідовну пріоритизацію та не залишає надійного audit trail. Якщо ж одразу перейти до автономної генерації, з’являється інший клас ризиків: модель може змінити taxonomy, перебільшити важливість оновлення, втратити provenance або опублікувати висновок, який людина не перевірила.
Тому нашою ціллю стала не «автоматизація контенту». Ми хотіли контрольований інформаційний конвеєр, у якому машина прискорює рутинні операції, а людина зберігає editorial authority.
Що ми свідомо не будували
Найкоротший шлях виглядав привабливо: scheduler читає RSS, LLM узагальнює новини, а workflow одразу створює або публікує статтю. Саме від цього варіанта ми відмовилися.
Автономний publisher оптимізує швидкість проходження happy path. Наші головні ризики жили в інших місцях: пропущений Critical Signal, невірна рекомендована дія, непомітна зміна категорій між українською та англійською версіями, втрата повного контексту джерела або непогоджена зміна вже опублікованого Digest.
Тому AI у Radar не має права:
- визначати фінальний склад Digest без людського review;
- самостійно затверджувати українську чи англійську версію;
- змінювати identity-поля між локалями;
- переводити site draft у published state;
- трактувати отриманий контент як інструкції;
- зберігати повні тексти джерел після закриття тижневого циклу.
Це не обмеження «через недовіру до AI». Це розподіл відповідальності відповідно до ціни помилки.
Чому Obsidian, а не окремий вебзастосунок
На початку окремий локальний web UI здавався природним рішенням. Він міг би показувати джерела, фільтри, статуси та кнопки approval. Але після discovery стало очевидно: основна робота тут — читання, порівняння, редагування Markdown і зв’язування артефактів. Obsidian уже давав зручний інтерфейс для цього класу задач.
Ми порівнювали п’ять підходів:
Окремий web app
Дає повний контроль UX, але створює другий продукт: UI, auth, storage, deployment і maintenance.
SaaS automation
Забезпечує швидкий старт та інтеграції, але дані й workflow залежать від зовнішньої платформи.
GitHub Actions
Добре автоматизує роботу за розкладом, але не дає зручного щоденного editorial workspace й ускладнює secrets та network boundary.
RSS reader
Дає найкращий базовий reading experience, але не має наших contracts, approval states, revisions і MDX transaction.
Obsidian із локальними plugins
Зберігає файли як artifacts і дає links та review у знайомому UI. Компроміс — підтримка власних plugins і дисципліна Vault contract.
Obsidian переміг не тому, що здатен замінити будь-яку application platform. Він переміг тому, що збігся з природою задачі. Source, Signal, Digest, Action Review, backup record і publication record можуть бути звичайними Markdown-файлами з frontmatter. Їх можна читати, порівнювати, індексувати та зв’язувати без окремої бази даних.
Vault став orchestration layer, але не єдиним місцем зберігання всього. Приватні Radar-артефакти живуть у локальному workspace. Контент сайту залишається під Git-контролем у зовнішньому репозиторії та доступний з Vault через окрему межу. Secrets не зберігаються у Vault. Повний отриманий текст джерела існує лише як тимчасовий контекст для генерації та видаляється після закриття weekly cycle.
Local-first не означає «безконтрольний набір файлів»
Файлова архітектура працює лише тоді, коли файли мають контракти. У спрощеному вигляді потік виглядає так:
Official Sources
      ↓
Source Registry → ingestion → deduplicated Signals
                                  ↓
                         structured AI analysis
                                  ↓
                         human review + actions
                                  ↓
                     UK Digest → approval hash
                                  ↓
                     EN Digest → own approval
                                  ↓
                   atomic UK/EN MDX export
                                  ↓
                    site checks → Git/PR → publish
У v0.1 production scope зафіксовано п’ять офіційних джерел: OpenAI, React, Next.js, GitHub Changelog і Cloudflare. Окремий mock Source використовується як контрольований fixture і не рахується шостим production Source. Розширення до двадцяти джерел свідомо перенесено у post-MVP backlog.
Кожен Signal отримує стабільну identity. Повторний ingestion має reuse існуючого файла замість дублювання. Якщо система не працювала певний час, recovery починається від останньої успішної перевірки, але дивиться не більше ніж на сім днів і не намагається відтворити кожен пропущений scheduler run окремо. Спочатку перевіряються Critical Primary і Discovery Sources, потім решта.
Recommended Action теж не є одноразовим AI label. Коли з’являється тематично пов’язаний Signal, дія може потребувати перегляду. Radar створює Action Review, а людина підтверджує або відхиляє зміну. Матеріали можна фільтрувати за актуальною рекомендованою дією, а результат має стабільний shareable URL на сайті.
Один Vault, але два джерела істини
Практична перевага такого рішення — з одного Obsidian Vault можна працювати і з Radar, і з контентом сайту. Проте це не означає, що всі файли мають однаковий статус.
Radar/ — приватний робочий простір. Тут живуть Sources, Signals, Digests, revisions, usage records і operational evidence. Репозиторій сайту — окреме джерело істини для опублікованого контенту. У Vault він доступний через контрольоване посилання, але retention, cleanup і backup Radar не мають права переходити цю межу.
Це рішення зняло суперечність між зручністю одного робочого інтерфейсу та необхідністю різних lifecycle rules. Чернетку можна читати поруч із Signal і пов’язаним Digest, але її публікаційна історія все одно належить Git. Backup Radar виключає зовнішній site content. Cleanup тимчасових текстів не торкається MDX. Export за замовчуванням створює draft: true; зміна на draft: false, PR і production publication залишаються окремими діями.
Таке розділення особливо важливе для AI workflow. Агент може підготувати артефакт у межах дозволеного кроку, але фізична близькість файлів не розширює його повноваження. Наявність доступу до site content не означає право публікації, а наявність повного тексту джерела під час analysis не означає право зберігати його назавжди.
Human-in-the-loop як частина архітектури
У багатьох AI-рішеннях human-in-the-loop означає останню кнопку «Approve». Для Radar цього недостатньо. Людина присутня у кількох різних gates, і кожен gate захищає окрему властивість системи.
- Source approval захищає provenance і правила використання джерела.
- Signal review захищає фактичність, severity та рекомендовану дію.
- Digest selection захищає редакційний фокус і різноманітність.
- UK approval фіксує canonical editorial content через hash.
- EN approval підтверджує переклад, але не дозволяє змінити tags, actions або identity.
- MDX export перевіряє обидва артефакти й виконує запис як одну транзакцію.
- Git/PR і site quality gate відокремлюють підготовлену чернетку від публікації.
Ці gates коштують часу. Вони не гарантують, що помилок не буде. Перший production cycle якраз показав дев’ять інтеграційних проблем — від stale plugin process до parity і revision-flow. Але кожна така проблема перетворилася на новий контракт, тест або явну операційну команду. Саме це робить систему контрольованою: помилка не просто виправляється локально, а змінює правила наступного проходу.
Де тут MAE
Engineering Radar реалізовано за підходом MAE — Managed Agentic Engineering. У нашому випадку це означало не «попросити агента побудувати Radar», а пройти керовану послідовність: discovery, формалізація бізнес-рішень, technical spikes, acceptance criteria, реалізація малими інкрементами, перевірка живими командами та документальне закриття scope.
MAE допоміг утримати три речі, які легко втратити в довгій agentic-сесії:
- Traceability. Чому рішення існує і яка вимога його породила.
- Approval boundaries. Де агент може діяти самостійно, а де потрібне рішення власника.
- Evidence. Чим підтверджено, що функціонал працює, і які KPI ще не виміряні.
Окремий детальний матеріал про MAE готується для OTAKOYI. Після його публікації ми додамо сюди посилання через підтримуваний механізм сайту.
Що означає «функціонально завершено»
На 14 серпня 2026 року Engineering Radar v0.1 отримав owner sign-off як functionally complete. Ця фраза має точну межу.
Підтверджено:
- 5 офіційних production Sources і контрольований mock fixture;
- 6 production Obsidian plugins;
- 49 структурованих Signal-файлів у поточному Vault inventory;
- 98 ізольованих plugin tests;
- deterministic Critical control: 7 із 7 незалежних причин;
- двомовний R2 Digest із 6 Signals, 7 tags і 3 Recommended Actions;
- site gate: lint, typecheck, 445 tests у 80 файлах і production build на 169 сторінок;
- encrypted backup та isolated restore фінального baseline: 199 файлів, production Vault не змінено.
Але функціональне завершення не дорівнює доведеній операційній ефективності. Для W33 не було active-time instrumentation, тому ми не заявляємо, що підготовка й review зайняли не більше 30 хвилин. Один двомовний Digest не доводить місячний KPI у 70%, а один цикл — cadence щонайменше три публікації на місяць. Ці показники потребують W34 confirmation і повного observation period.
Навіть зафіксована OpenAI-вартість — $0.01225250 — є лише partial baseline для Signal analysis. Вона не включає Digest generation, тому не може подаватися як повна вартість циклу.
Це обмеження важливіше за красиві headline numbers. Якщо система побудована для довіри, її історія також має чесно відділяти виміряні факти від оцінок.
Переваги й недоліки рішення
Після першого production cycle головні переваги очевидні:
- artifacts залишаються читабельними Markdown-файлами;
- editorial workflow живе у знайомому Obsidian, без окремого web UI;
- AI ізольований контрактами й не володіє publication decision;
- approval hashes роблять непомітне редагування після погодження видимим;
- двомовний export перевіряється як пара;
- revisions дозволяють доповнювати поточний Digest, не переписуючи історію;
- backup, retention та recovery є частиною продукту, а не зовнішньою домовленістю.
Недоліки так само реальні:
- шість власних plugins — це maintenance surface;
- Obsidian hot reload і stale process створюють специфічні operational failure modes;
- file-based contracts вимагають суворої schema validation;
- локальний workflow складніше запускати без графічного інтерфейсу — тому CLI винесено в окрему третю фазу;
- human gates обмежують throughput;
- повну цінність можна оцінити лише після кількох регулярних циклів, а не після успішного demo.
Для нашого сценарію це прийнятний обмін. Ми оптимізували не кількість автоматично створених текстів, а контрольованість рішення та можливість пояснити походження кожного публічного висновку.
Що буде далі
У наступній частині розберемо Source Registry: чому Source — це контракт, як Radar створює стабільні Signals, що означають created і reused, як працює recovery window і чому повний текст джерела має короткий життєвий цикл.
Далі будуть structured AI analysis, двомовний Digest та atomic MDX export, розбір дев’яти реальних помилок першого production cycle і фінальний tutorial для відтворення системи у власному Obsidian.
А поки цікаво порівняти підходи: у вашому workflow найбільший ризик — пропустити важливий Signal, втратити контекст чи занадто рано віддати AI право публікації?
← Назад до блогу